가이드
황금키워드 프로그램 만들기, 키워드 23개 돌려보고 알게 된 것들
2026년 9월 22일
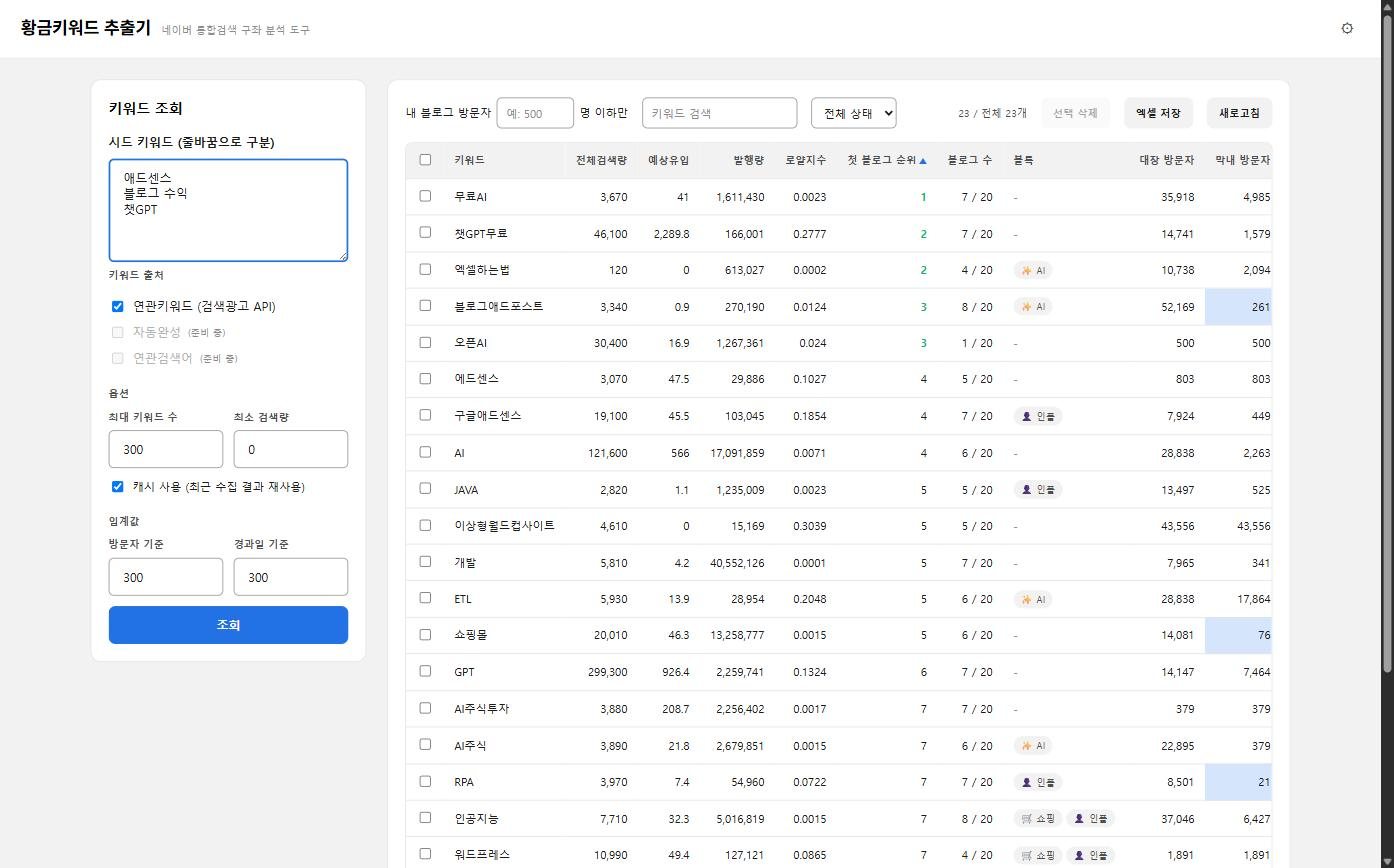
한 줄 답변: 황금키워드 프로그램 만들기는 화면 그리기가 아니라 "어떤 숫자를 어디서 가져올지"를 정하는 일이 대부분입니다. 노마랩은 먼저 나온 엑셀 기반 제품의 결과 파일을 컬럼 하나씩 뜯어 출처를 매핑하고(2026년 8월 26일), 네이버 검색광고 API·검색 API·통합검색 화면·블로그 방문자 위젯 네 곳에서 값을 모아 66컬럼 엑셀로 내보내는 구조를 잡았습니다. 2026년 8월 28일 첫 실사용에서 키워드 23개를 실패 0건, 차단 없이 완주했고 속도는 키워드 하나에 약 26초였습니다.
아래 숫자는 노마랩 개발 기록에 남은 실측값이고 기준일을 문단마다 적었습니다. 출시 준비 중이라 앞으로 바뀔 수 있습니다.
왜 직접 만들기로 했나요?
시작은 같은 일을 하는 엑셀 기반 제품의 결과 파일을 본 것이었습니다. 키워드마다 검색량, 발행량, 상위 글 방문자를 한 줄로 보여주는 구성이 좋았고, 판단 기준으로 "내 방문자보다 작은 블로그가 상위에 있는가"를 쓰는 관점이 정확했습니다. 먼저 이 판을 만든 분들이 잘 짚은 부분입니다.
다만 우리에게 맞지 않는 점이 셋 있었습니다. 엑셀 매크로로 돌아가서 MS365 엑셀이 필요했고, 결과가 파일로만 남아 정렬과 걸러 보기를 매번 엑셀에서 다시 해야 했고, 무엇보다 컬럼 명세가 2024년에서 2025년 사이 네이버 화면 기준이라 지금과 맞지 않았습니다. 그래서 관점만 가져오고 수집과 화면은 새로 만들기로 했습니다.
화면은 웹 화면을 데스크톱 창에 얹는 구조로 만들었습니다. 결과 표와 필터가 이 제품의 전부라서, 화면이 곧 제품인 경우에 쓰는 방식을 골랐습니다. 비개발자가 AI와 대화하며 프로그램을 만드는 방식은 바이브코딩으로 외주 4건 받은 이야기에 적어 두었습니다.
컬럼 66개는 어떻게 정했나요?
2026년 8월 26일에 먼저 나온 제품의 결과 파일(시트 3개)을 열고, 컬럼 하나하나에 "이 값은 어디서 오는가"를 붙였습니다. 출처는 다섯 종류로 정리됐습니다. 검색광고 API(검색량·클릭률·경쟁정도), 네이버 검색 API(발행량), 통합검색 화면(순위·구성), 블로그 글 페이지(발행일·글자수·이미지수), 블로그 방문자 위젯(하루 방문자). 나머지는 이 값들로 계산하는 컬럼이었습니다.
이 작업에서 확인한 것 두 가지가 제품 방향을 정했습니다. 하나는 로얄지수가 그냥 전체 검색량을 전체 문서량으로 나눈 값이라는 것입니다. 결과 파일 54행을 전부 대조해 산식이 일치했습니다. 다른 하나는 원본의 "점수" 컬럼을 끝내 역산하지 못했다는 것입니다. 후보 산식을 바꿔 가며 54행과 맞춰 봤지만 40행까지만 일치했습니다. 그래서 점수는 베끼지 않고 자체 산식으로 설계하기로 했습니다. 상위 글마다 방문자가 기준보다 작으면 점수를 주고, 글이 오래됐으면 조금 더 주는 방식이고 기준값은 사용자가 바꿉니다.
1차 버전 범위도 이때 정했습니다. 통합검색 결과와 내 글 순위 추적은 포함, 경쟁 블로거의 글 목록을 모으는 기능은 보류입니다. 그렇게 남은 컬럼이 66개이고 자동필터·조건부서식·틀고정을 미리 걸어 엑셀로 저장합니다.
만들다가 알게 된 가장 큰 것은 무엇인가요?
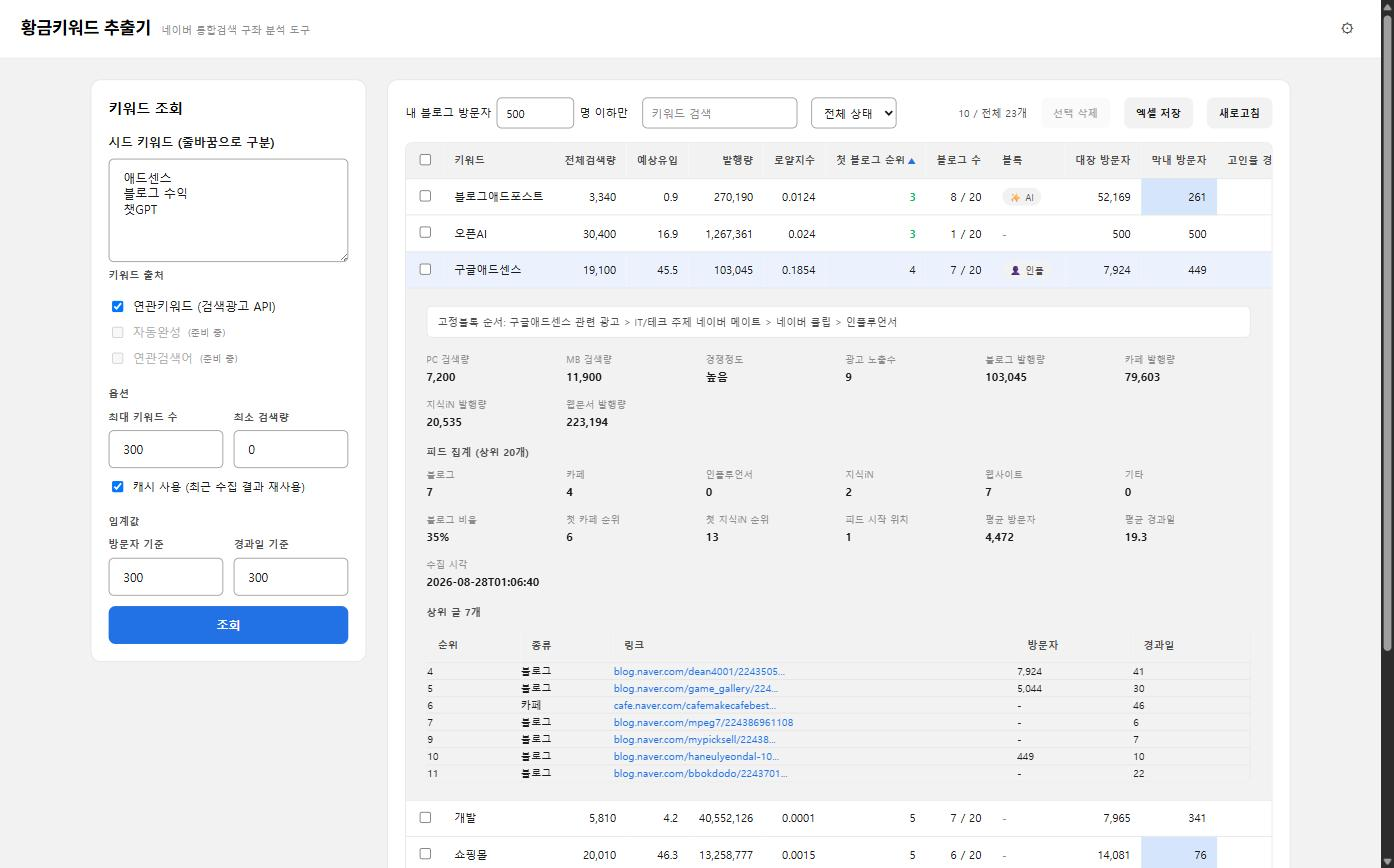
네이버 통합검색 화면 구조가 이미 바뀌어 있었다는 것입니다. 2026년 8월 26일에 키워드 세 개로 통합검색 화면을 직접 받아 구조를 확인해 보니, 예전 도구들이 컬럼으로 쓰던 "1탭에서 9탭", "인기글 위치", "스마트블록 위치" 같은 이름 있는 구좌 나열이 더 이상 없었습니다.
지금 구조는 위쪽에 이름 있는 고정 블록 몇 개(AI 브리핑, 관련 광고, 인플루언서, 이미지, 뉴스 같은)가 있고, 그 사이와 아래로 블로그 글·카페 글·인플루언서 글·지식iN·일반 웹사이트가 섞여 순위가 매겨지는 통합 피드입니다. "몇 번째 탭"이라는 질문 자체가 지금 네이버에는 대응물이 없습니다.
그래서 컬럼을 재정의했습니다. "몇 번째 탭" 대신 "블로그 글이 처음 나오는 자리", "인기글 위치" 대신 "상위 20개가 블로그·카페·인플루언서·지식iN 중 무엇으로 채워졌는가", 그리고 AI 브리핑이나 쇼핑 블록이 떴는지를 표시하는 값입니다. 옛 명세를 그대로 베꼈다면 존재하지 않는 자리를 찾는 프로그램이 됐을 겁니다.
데이터는 어디서 가져오나요?
검색량과 연관키워드는 네이버 검색광고 API를 씁니다. 2026년 8월 26일 실호출에서 힌트 키워드 "엑셀하는법" 하나로 연관키워드 173개가 한 번에 내려왔고, 그중 75개는 검색량이 숫자 대신 "< 10"으로 왔습니다. 검색량 10 미만은 값을 숨기기 때문입니다.
발행량은 중간에 길이 바뀌었습니다. 네이버 검색 오픈API가 개발자센터의 신청 목록에서 빠지고 네이버클라우드의 NAVER API Hub로 이관된 것을 2026년 8월 26일에 확인했습니다. 엔드포인트와 인증 헤더가 달라져서 예전 주소로는 인증이 거절됩니다. 새 쪽으로 다시 발급해 2026년 8월 27일에 블로그·카페·지식iN·웹문서 발행량 조회가 정상 동작하는 것을 확인했습니다.
이때 숫자 하나가 눈에 걸렸습니다. "엑셀하는법"의 블로그 발행량이 612,548로 나왔는데 참고한 옛 결과 파일에는 같은 칸이 7이었습니다. 원본이 어디서 가져온 값인지 알 수 없어서, 검색 API 값을 그대로 쓰고 로얄지수는 절대값이 아니라 키워드끼리 비교하는 용도로만 쓰기로 정했습니다.
API 키는 두 종류 모두 사용자 본인 계정에서 발급해 넣습니다. 우리 키를 프로그램에 넣어 두면 전체 사용자가 한 한도를 나눠 쓰게 되고, 한 사람이 많이 돌리면 나머지가 멈춥니다. 네이버 검색량 조회를 브라우저 확장으로 만들어 본 일당백 플러그인 때도 같은 판단을 했습니다.
키워드 하나에 26초, 왜 이렇게 느리게 만들었나요?
일부러 느리게 만들었습니다. 키워드 하나를 조사하려면 검색광고 API 1회, 발행량 조회 1회, 통합검색 1회, 상위 글 확인 최대 7회, 방문자 확인 최대 7회가 듭니다. 키워드 100개면 통합검색 100회에 블로그 관련 요청이 최대 1,400회입니다. 여기에 지연을 두지 않으면 차단을 부릅니다.
그래서 통합검색 요청 사이에 4초, 블로그 확인 사이에 3초를 두고 여기에 무작위 여유를 더 얹었습니다. 2026년 8월 28일 첫 실사용에서 시드 "자동화프로그램" 하나를 넣고 연관키워드 300개를 목표로 돌렸더니, 23개를 수집한 시점까지 전부 성공, 실패 0건, 차단 없음이었습니다. 속도는 키워드 하나에 약 26초, 300개 기준 예상 소요는 162분으로 표시됐습니다. 빠른 것보다 안 끊기는 쪽을 택한 결과입니다.
차단 신호가 잡히면 그 자리에서 멈추고, 조회한 키워드는 PC 안의 작은 데이터베이스에 저장해 다시 조회하지 않습니다. 중간에 멈췄다 다음 날 이어 돌려도 앞의 일을 반복하지 않습니다.
리스크는 분명히 말씀드립니다. 네이버가 검색 화면이나 정책을 바꾸면 값이 비거나 수집이 멈출 수 있어 그때마다 패치가 필요합니다. 하루 목표를 낮게 잡고 나눠 돌려야 하며, 아무리 조심해도 계정이나 IP가 제한될 가능성이 0은 아닙니다.
실수로 배운 것은 무엇인가요?
두 개 있습니다. 첫째, 차단 판정 기준을 잘못 잡았습니다. 받아 온 화면에 "captcha"라는 글자가 있으면 차단으로 봤는데, 정상 검색 결과 화면에도 캡차 관련 주소가 항상 들어 있어 전부 차단으로 잡혔습니다. 실제로 쓸 수 있는 기준은 응답 코드가 200이 아닐 때, 화면 크기가 비정상으로 작을 때, "자동입력 방지" 문구가 있을 때 세 가지였습니다.
둘째, 기본값 때문에 의도하지 않은 수집이 시작된 일이 있습니다. 진행률 표시를 확인하려고 시드 하나만 넣어 작업을 걸었는데, 연관키워드 확장 옵션이 기본으로 켜져 있어서 키워드 173개로 불어나 실제 수집이 시작됐습니다. 약 25초 뒤에 멈췄고 차단은 없었지만, 사용자도 같은 실수를 할 수 있다는 뜻이었습니다. 그래서 조회를 누르기 전에 "최대 몇 개, 예상 몇 분"을 보여주고 확인받는 화면을 남은 일 목록에 넣었습니다.
테스트는 36개를 만들어 두고 고칠 때마다 돌립니다. AI와 대화하며 고치는 방식에서 테스트가 없으면 다른 데가 조용히 망가진 것을 알 수 없습니다.
지금 어디까지 왔고 남은 일은 무엇인가요?
2026년 8월 28일 기준으로 키워드 확장, 수집, 결과 표 화면, 깜냥 필터, 66컬럼 엑셀 저장까지 동작합니다. 남은 일은 키워드 30개에서 50개를 연속으로 완주시켜 차단 임계를 확인하는 것(23개까지는 확인됐습니다), 엑셀 저장 다이얼로그 실확인, 조회 전 확인 화면, 이용권 연결과 설치 파일 빌드입니다.
기능 설명과 컬럼 구성은 황금키워드 추출 프로그램 글에 따로 정리했고, 화면 세 장은 황금키워드 제품 페이지에서 보실 수 있습니다. 지금은 출시 준비 중이라 가격과 체험 기간은 정해지지 않았습니다.
자주 묻는 질문
코딩을 모르는 사람이 이런 프로그램을 만들 수 있나요?
가능합니다. 노마랩은 클로드코드와 VSCode로 대화하면서 만들었습니다. 다만 화면을 그리는 일보다 "어떤 값을 어디서 가져올지"를 정하는 일이 훨씬 오래 걸립니다. 그 판단은 AI가 대신해 주지 않습니다.
비슷한 프로그램을 만들려면 무엇부터 해야 하나요?
먼저 나온 제품의 결과 파일을 구해 컬럼마다 출처를 붙여 보는 것부터 하세요. 우리는 이 작업에서 "베낄 수 없는 컬럼"과 "이미 낡은 컬럼"을 찾았고, 그게 제품 방향이 됐습니다. 화면부터 만들면 나중에 다 뒤집습니다.
수집 속도를 더 올릴 수는 없나요?
기술적으로는 올릴 수 있지만 올리지 않았습니다. 네이버 검색 결과를 짧은 간격으로 계속 열면 차단과 캡차를 부릅니다. 키워드 하나에 약 26초는 안 끊기는 쪽을 택한 결과이고, 큰 목록은 며칠에 나눠 돌리는 것을 전제로 만들었습니다.
API 키를 직접 발급해야 하나요?
네. 네이버 검색광고 API 키와 검색 API 키는 사용자 본인 계정에서 발급해 넣습니다. 프로그램에 우리 키를 넣으면 모든 사용자가 한 한도를 나눠 쓰게 되어 한 사람 때문에 전체가 멈추기 때문입니다.
출시 소식을 먼저 받고 싶으시면
만들면서 남긴 기록을 그대로 적었습니다. 지금 키워드 조사를 어떻게 하고 계신지, 어느 단계가 제일 번거로우신지 알려주시면 남은 기능 순서에 반영합니다. 황금키워드 제품 페이지에서 실제 화면을 먼저 보시고, 출시 시점은 카카오톡 채널로 안내해 드립니다.